
浏览器缓存
web缓存是只一个 web 资源(html、图片、js、css、数据等)存在于 web 服务器和浏览器之间的副本
缓存会根据进来的请求保存输出内容的副本;当下一个请求来临的时候,如果是相同的 URL,缓存会根据缓存机制决定是直接使用副本响应请求还是向源服务器再次发送请求。比较常见的。
比较常见的就是浏览器会缓存访问过网站的网页,当再次访问这个 URL 地址的时候,如果网页没有更新,就不会再次下载网页,而是直接使用本地缓存的网页。只有当网站明确标识资源已经更新,浏览器才会再次下载网页。至于浏览器和网站服务器是如何标识网站页面是否更新的机制,将在后面介绍。
缓存可以减少网络带宽的消耗、减低服务器的压力、减少网络延迟,加快页面打开速度
这里主要记录浏览器缓存。
Memory Cache
memory cache 是内存中缓存,就是将资源缓存到内存中,等待下次访问时不需要重新下载资源,而是直接从内存中读取。从效率上来讲它是最快的,但也是存活时间最短的。
几乎所有的网络请求都会被浏览器自动加入到 memory cache 中,所以可能数量很多,所以注定了 memory cache 存活时间短;
当一个 tab 页签被关闭之后那么 memory cache 也就失效了,极端情况下(例如一个页面的缓存就占用了超级多的内存)那可能在 tab 页签没关闭之前,排在前面的缓存就已经失效了。
memory cache 是浏览器命中的第一个缓存
Disk Cache
disk cache 是储存在磁盘中的缓存,从存储效率上来讲是比内存慢的,但比起网络请求还是快了不少的。绝大部分的缓存都来自 disk cache,他的优势在于存储容量和存储时长。
那么浏览器是如何决定将资源放进的内存还是硬盘?
- Base64 格式的图片,几乎永远可以被塞进
memory cache - 比较大的 js、css 文件会被直接丢到磁盘,反之丢进
memory cache - 内存使用率比较高的时候,文件优先进入
disk cache
Service Worker Cache
Service Worker 是独立于主线程之外的一个线程,借鉴了 Web Worker 的思路。由于他脱离了浏览器的窗体,所以无法直接访问 dom。
虽然如此,但他仍然能够帮助我们完成很多有用的功能,比如离线缓存、消息推送、网络代理等。离线缓存就是 Service Worker Cache
在浏览器的中打开控制台 --> Application 面板 --> Cache --> Cache Storage 中可以找到存在 Service Worker Cache 中的数据。
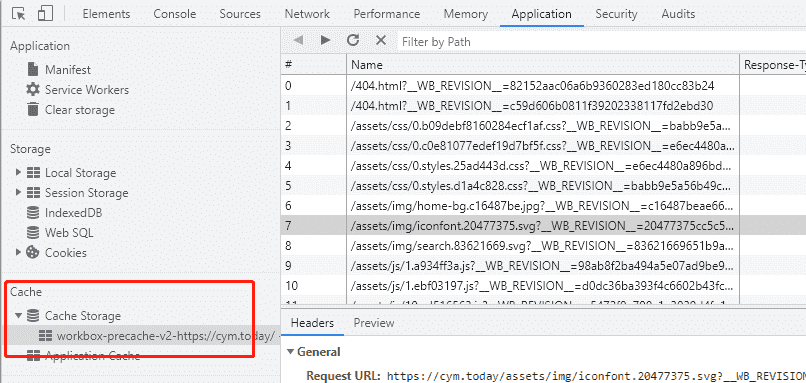
出于安全问题的考虑,Service Worker 只能被使用在 https 或者 本地的 localhost 环境下
HTTP Cache
HTTP Cache 分为强缓存和协商缓存。优先级较高的是强缓存,在命中强缓存失败的情况下才会走协商缓存,看一张图以及下面的解释来理解一下 HTTP Cache
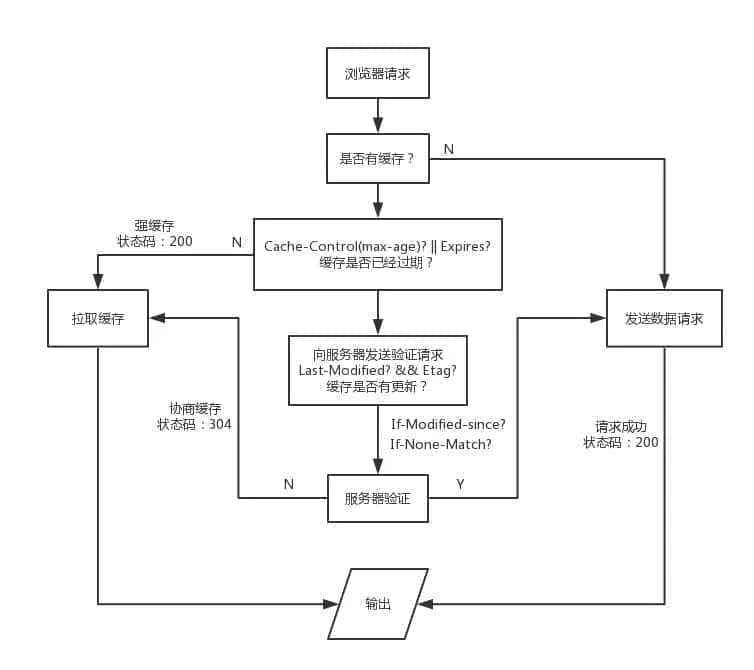
强缓存
强缓存是利用 http 头中的 Expires 和 Cache-Control 两个字段来控制。
在强缓存中,当请求再次发出时,浏览器会根据其中的 expires 和 cache-control 判断目标资源是否“命中”强缓存,若命中则直接从缓存中获取资源,不会再与服务端发生通信。
Expires
这是 http 1.0 的字段,表示缓存到期时间,是一个绝对的时间(当前时间 + 缓存时间)
Expires: Mon, 23 Dec 2019 10:15:36 GMT在响应消息头中设置这个字段后,就可以告诉浏览器,在未过期之前不需要再次请求。
但是,这个字段设置的时候有两个缺点:
- 由于是绝对时间,用户可能修改自己本地时间,从而导致浏览器缓存实效。即使用户没有修改,服务器时间和浏览器时间可能时间不一致,致使缓存实效
- 写法复杂,表示时间的字符串多个空格,少个字母,都会导致非法属性从而设置失效
Cache-Contorl
已知 Expires 的缺点后,在 http 1.1 版本中新增了 Cache-Control 字段,该字段表示缓存的最大有效时间,在该时间内,客户端不需要向服务器发送请求
两者的区别就是 Expires 是绝对时间,而 Cache-Control 是相对时间。Cache-Control 格式如下:
  # 在 30 天内有效,max-age 后面是个秒数
Cache-control: max-age=2592000下面记录下 Cache-Control 字段的常用值:
- max-age:设置缓存存储的最大周期,超过这个时间缓存被认为过期(单位秒)。与
Expires相反,时间是相对于请求的时间。 public与private是针对资源是否能够被代理服务缓存而存在的一组对立概念。- public:所有内容都将被缓存(客户端和代理服务器都缓存)
- private:该资源只能被浏览器缓存。
pricate是默认值
no-cache和no-store:- no-cache:绕开了浏览器,跳过当前缓存,发送
http请求,也就是直接进行协商缓存。 - no-store:不使用任何缓存。
- no-cache:绕开了浏览器,跳过当前缓存,发送
若 Expires 和 Cache-Control 同时存在,那么以 Cache-Control 为主
缓存位置
以本博客为例,看看缓存保存在了哪里,下图是第一次进来网站,然后刷新一次后的效果
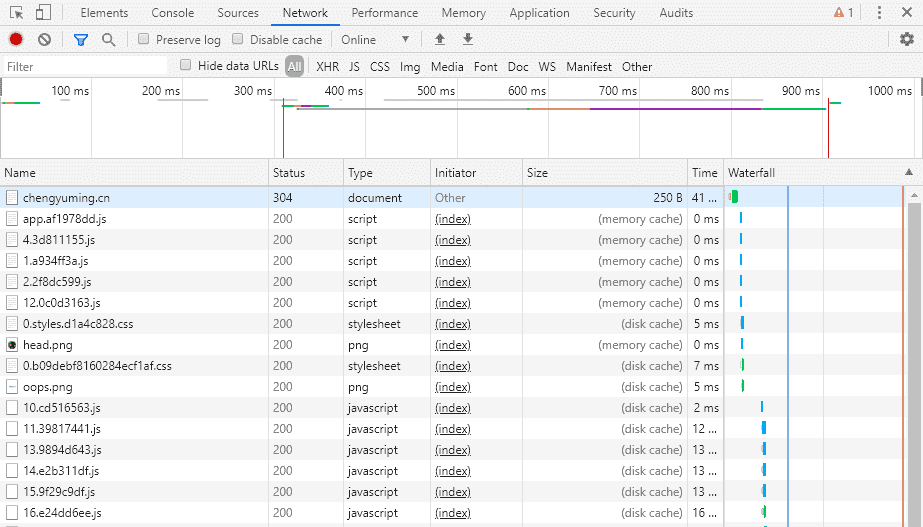
其中我们可以看到状态码有 200 和 304,200 后 size 属性中有 memory cache(以前叫做 from memory cache)和 disk cache(以前叫做 from disk cache)标明了,该缓存来自内存还是硬盘,状态码 304 表示走了协商缓存
当我们关闭了博客再次打开之后,就会看到大部分的 size 字段变成了 disk cache,说明关闭页面后内存中保存的数据就没有了,会被放到磁盘中
第一次打开博客之后,所有的请求都是都是 200 但是 size 字段是文件真实的大小,说明没有走缓存,base64 例外,所有的 base64 格式的图片几乎永远可以被塞进 memory cache 中
协商缓存
当强缓存实效(超过超过规定时间)时,就会使用协商缓存了。协商缓存机制下,浏览器需要向服务器去询问缓存的相关信息,由服务器来决定缓存是否有效。
如果服务端的提示资源未被改动(Not Modified),资源会被重定向到浏览器缓存,这种情况下的对应的状态码是 304
协商缓存判断是根据两组字段来判断:Last-Modified & If-modified-Since 和 Etag & If-None-Match
Last-Modified 和 If-modified-Since
Last-Modified 是服务器相应请求时,返回资源文件在服务器最后的修改时间,如图所示
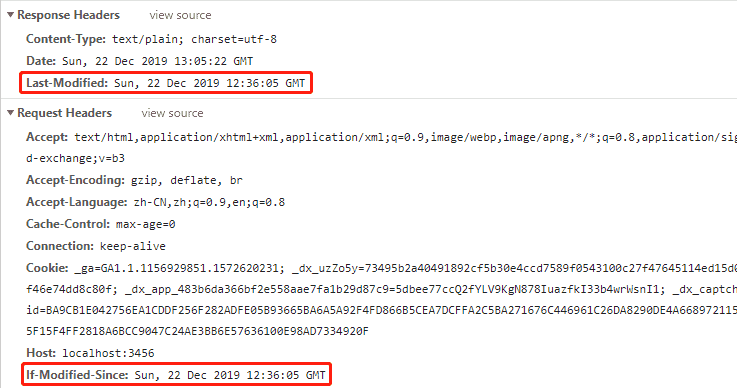
If-Modified-Since 则是客户端再次发送请求时,携带上上次请求返回的 Last-Modified 的内容,通过这个字段来告诉服务器该资源上次请求返回的最后修改的时间。
服务器收到请求后发现请求头中有 If-Modified-Since 字段,会根据 If-Modified-Since 字段值与该资源在服务器中的最后修改时间做判断,若服务器资源最后修改时间大于 If-Modified-Since 值,则重新返回资源,状态码为 200;否则,返回 304,表示资源未更新,资源会被重定向到浏览器缓存
但是他还是有一定缺陷的:
- 如果资源更新时间是秒以下为单位的,那么该缓存是不能被使用的,因为它的时间单位最低是秒。
- 如果文件是服务器动态生成的,那么该方法的更新永远是生成的时间,尽管文件可能没有变化,所以起不到缓存的作用
完整代码实现如下:
const http = require('http')
const fs = require('fs')
const path = require('path')
const url = require('url')
const PORT = 3456

http
  .createServer((req, res) => {
    const pathname = url.parse(req.url).pathname
    if (pathname === '/') {
      const filename = path.resolve(__dirname, './files/1.txt')
      fs.stat(filename, (err, stat) => {
        if (err) {
          res.statusCode = 404
          return res.end('Not Fount')
        }
        if (stat.isFile()) {
          const timeGMT = stat.ctime.toGMTString()
          console.log(timeGMT)
          if (req.headers['if-modified-since'] === timeGMT) {
            console.log('文件未改动')
            res.statusCode = 304
            return res.end()
          }
          // 让浏览器以 utf-8 格式解析文本
          res.setHeader('Content-Type', 'text/plain; charset=utf-8')
          res.setHeader('Last-Modified', timeGMT)
          console.log('没有走缓存')
          fs.createReadStream(filename).pipe(res)
        }
      })
    }
  })
.listen(PORT)Etag 和 If-None-Match
Etag 是服务器响应请求时,返回资源文件的唯一标识(由服务器生成),同时也解决了 Last-Modified 存在的缺陷,如图:
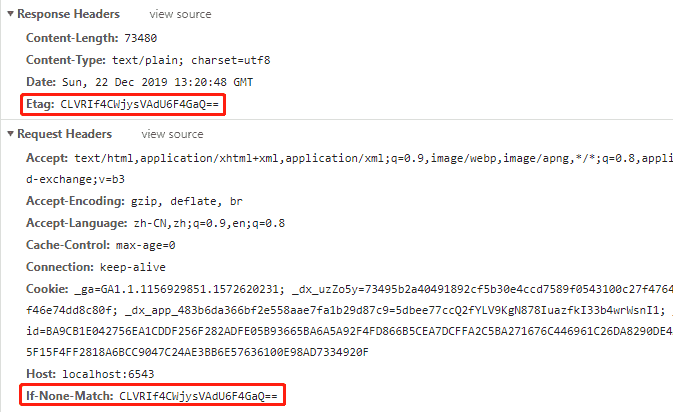
If-None-Match 是浏览器再次发送该请求时,携带上次请求返回的唯一表示(Etag)值,通过此字段告诉服务器该资源上次请求返回的唯一标识。
服务器收到请求后发现请求头中 If-None-Match 字段,会根据 If-None-Match 的字段值与该资源在服务器的 Etag 值作对比,如果一样则返回 304,代表资源未更新,继续使用缓存;不一样则重新返回文件,状态码 200
Etag 的优先级高于 Last-Modified,同时存在则取 Etag
完整代码实现如下:
const http = require('http')
const fs = require('fs')
const path = require('path')
const url = require('url')
// hash 加密用
const crypto = require('crypto')
const PORT = 6543

http
  .createServer((req, res) => {
    const pathname = url.parse(req.url).pathname
    if (pathname === '/') {
      const filename = path.resolve(__dirname, './files/etag.txt')
      fs.stat(filename, (err, stat) => {
        if (err) {
          res.statusCode = 404
          return res.end('Not Fount')
        }
        if (stat.isFile()) {
          // Etag 的实体内容,根据文件的内容计算出一个唯一的 hash 值
          const md5 = crypto.createHash('md5')
          const rs = fs.createReadStream(filename)
          // 要先写入响应头在写入响应体
          const arr = []
          rs.on('data', chunk => {
            md5.update(chunk)
            arr.push(chunk)
          })
          rs.on('end', () => {
            const etag = md5.digest('base64')
            if (req.headers['if-none-match'] === etag) {
              console.log(req.headers['if-none-match'])
              console.log('文件未改动')
              res.statusCode = 304
              return res.end()
            }
            console.log('没有走缓存')
            // 让浏览器以 utf8 格式解析文本
            res.setHeader('Content-Type', 'text/plain; charset=utf8')
            res.setHeader('Etag', etag)
            res.end(Buffer.concat(arr))
          })
        }
      })
    }
  })
.listen(PORT)node 实现缓存
完整代码,已上传 github
Push Cache
Push Cache 是指 HTTP2 在 server push 阶段的缓存
Push Cache是缓存的最后一道防线。浏览器只有在Memory Cache、HTTP Cache和Service Worker Cache均未命中的情况下才会去询问Push CachePush Cache是一种存在于会话阶段的缓存,当会话结束的时候,缓存也随之释放- 不同的页面只要共享了一个
HTTP/2连接,那么它们就可以共享一个Push Cache Push Cache可以参考这篇文章